Herkunft
AS OriginBox im Detail
Die Seite beschreibt die Arbeitsweise der AS OriginBox: Namen werden zunächst analysiert und strukturiert und anschließend einzelnen Sprach- und Kulturräumen zugeordnet.
Arbeitsweise der AS OriginBox
Die Arbeitsweise der AS OriginBox unterscheidet sich von anderen Verfahren, mit denen der sprachliche und kulturelle Hintergrund einer Person auf Basis des Namens identifiziert wird, im Wesentlichen dadurch, dass der Vor- und Nachname und evtl. weitere Namenselemente zunächst analysiert, strukturiert und anschließend separat bestimmten Sprach- und/oder Kulturräumen zugeordnet werden. Als Kombination aller Einzelinformationen wird schließlich ein Gesamtergebnis für die mögliche Zugehörigkeit generiert.
Abgrenzung zu herkömmlichen Verfahren
Herkömmliche Verfahren, die beispielsweise auf bestimmten Endungen von Namen basieren oder einfach in einem Namen insgesamt nach bestimmten Worten, Zeichenketten oder auch nach Namen aus einer definierten Vor-/Nachnamensliste suchen, können die Treffsicherheit der AS OriginBox nicht bieten.
Die drei Hauptschritte
Generell kann man die Arbeitsweise der AS OriginBox in drei Hauptschritte unterteilen:
- Zuerst wird ein eingegebener Name in eine korrekte Struktur überführt, sodass Vorname, Nachname, Präfix, etc. isoliert zur Verfügung stehen.
- Danach werden Zuordnungen des Vor- und Nachnamens zu möglichen Sprach- und Kulturräumen separat ermittelt.
- Schließlich wird aus der Kombination von Vor- und Nachname auf Basis eines Regelwerks das Sprach- und/oder Kulturkennzeichen für den Gesamtnamen bestimmt.
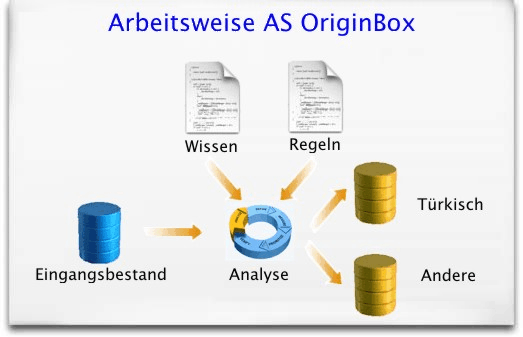
Veranschaulichung am Beispiel türkischer Namen
Die Grafik veranschaulicht den Vorgang am Beispiel von Namen aus dem türkischen Sprachraum, die identifiziert werden sollen.
Unterstützte Sprach- und Kulturräume
Die AS OriginBox kann in Online-Prozessen und in Batch-Prozessen eingesetzt werden. Derzeit werden dabei folgende Sprach- und Kulturräume unterstützt:
Mittel-, West- und Nordeuropa
- Deutsch (Deutschland, Österreich, Schweiz)
- BeNeLux (Niederlande, Belgien, Luxemburg)
- Französisch (z. B. Frankreich, Schweiz, Kanada, teilweise aber auch Belgien)
- Italienisch (Italien, Schweiz)
- Englisch (z. B. England, Schottland, Irland, USA, Australien)
- Skandinavisch (z. B. Schweden, Norwegen, Dänemark, Finnland, aber auch Island, etc.)
Ost- und Südosteuropa
- Ex-UdSSR (z. B. Russland, Litauen, Georgien, Estland, Armenien, Ukraine, etc.)
- Ex-Jugoslawisch (z. B. Serbien, Bosnien und Herzegowina, Kroatien, Montenegro, Slowenien, Mazedonien)
- Ex-Tschechoslowakei (tschechischer und slowakischer Sprach- und Kulturraum)
- Polnisch (Polen, teilweise auch Russland, Litauen, Belarus, Ukraine)
- Osteuropäisch (z. B. osteuropäischer Sprach- und Kulturraum, sofern nicht näher spezifiziert oder in eine der anderen Gruppen eingeordnet)
- Griechisch (z. B. Griechenland, teilweise Zypern, Mazedonien, Albanien)
- Türkisch (z. B. Türkei inkl. des kurdischen Sprach- und Kulturraums, teilweise Zypern, Bulgarien)
Weitere Sprach- und Kulturräume
- Spanisch/Portugiesisch (z. B. Spanien, Portugal, Südamerika)
- Arabisch (z. B. die arabischen Staaten Nordafrikas, Tunesien, Marokko, Algerien, etc.)
- Afrikanisch (nicht arabischer Sprach- und Kulturraum Afrikas)
- Asiatisch (z. B. Vietnam, China, Japan, Thailand, etc.)
Allgemeine Hinweise zur Bestimmung des Sprach- und Kulturraums
Bevor einzelne Sprach- und Kulturräume beschrieben werden, muss an dieser Stelle ausdrücklich betont werden, dass es bei der Ermittlung des Sprach- und Kulturraumes eines Namens nicht um die Ermittlung seiner ethnischen Herkunft geht.
Besonders deutlich wird dies beispielsweise bei der Kategorie Ex-Jugoslawien: Hier wird nicht zwischen Slowenen, Mazedoniern, Kroaten, Bosniaken oder Serben unterschieden, da dies aus Datenschutzgründen bedenklich wäre. Zum anderen wäre eine solche Zuordnung aber auch im Sinne der eigentlichen Bestimmung überhaupt nicht förderlich, da in den Jahren des Bestehens Jugoslawiens längst eine erhebliche Vermischung all dieser Kreise stattgefunden hat.
Aus diesem Grunde denken wir auch, dass der inzwischen etablierte Begriff des „Ethno-Marketings“ äußerst unglücklich und missverständlich gewählt wurde. Der durchaus positive Grundgedanke, der hinter dieser Art des Marketings steht, nämlich die zielgerichtete Kommunikation mit einem bestimmten Sprach- und Kulturraum unter Berücksichtigung dessen ganz spezieller Bedürfnisse, wird hierbei oft durch den faden Beigeschmack des Wortes Ethno in den Hintergrund gerückt.
Osteuropäische Namen
Unter dem Begriff „Osteuropa“ haben wir bei unserer AS OriginBox alle ehemaligen Staaten des Warschauer Pakts zusammengefasst, für die keine differenzierte Sprache und/oder Kultur identifiziert werden kann.
- Alle Staaten der ehemaligen UdSSR (z. B. Russland, Litauen, Georgien, Estland, Lettland, Moldawien, etc.) unterscheiden sich durchaus voneinander. Das Problem hierbei sind auch die asiatischen Länder der ehemaligen Sowjetunion, die natürlich durchaus Überschneidungen mit asiatischen Herkünften aufweisen können.
- Ex-Jugoslawien ist heute unterteilt in Slowenien, Mazedonien, Serbien & Montenegro (Rest-Jugoslawien), Bosnien-Herzegowina und Kroatien. Insbesondere in Bosnien-Herzegowina ist der Anteil der Moslems (der sogenannten Bosniaken) mit 38% sehr hoch, sodass sich hier auch eine ganze Reihe von Namen finden, die Ähnlichkeiten mit den arabischen bzw. auch den türkischen Namen aufweisen. Allerdings gibt es dennoch einige Trennmerkmale, die dann zu der Einordnung dieser Namen zu Osteuropa und nicht zum türkischen oder arabischen Sprachraum geführt haben.
- Albanien und hier insbesondere auch die Kosovo-Albaner weisen wiederum recht eigenständige Namen auf, die sich von den jugoslawischen oder russischen Namen weitestgehend unterscheiden.
- Auch Armenien gehört in der AS OriginBox derzeit zu Osteuropa, wenn auch die armenischen Namen deutliche Unterschiede zu den anderen, osteuropäischen Ländern aufweisen.
Insgesamt gesehen wird der wachsenden Bedeutung Osteuropas in künftigen Versionen der AS OriginBox mehr Gewicht beigemessen, sodass dann der Sprach- und Kulturraum detaillierter bestimmt werden kann. Erste Tests zeigen einen zu erwartenden Qualitätsstand wie z. B. bei den Türken (d. h. die einem osteuropäischen Land fälschlicherweise zugeordneten Namen erreichen die gleichen prozentualen Anteile).
In dieser Gruppe fällt weiter auf, dass viele ziemlich eindeutig zu Osteuropa zu zählende Namen aufgrund eklatanter Schreibfehler und der unterschiedlichen Umsetzung der kyrillischen Schreibweisen zu nicht erkannten Nachnamen führten. Oft sind jedoch wegen der Problematik der Umsetzung der kyrillischen Schriftzeichen auch unterschiedliche Schreibweisen des gleichen Namens im Umlauf, z. B. „Woronin“ oder „Voronin“.
Türkische Namen
Unter dem Begriff „türkischstämmiger Name“ verstehen wir Namen aus dem türkischen Sprach- und Kulturraum, also natürlich auch die vielen kurdischen Namen. Es wird also keinerlei Eingrenzung auf die vielfältigen ethnischen Gruppen in der Türkei vorgenommen.
Von den ca. 10,5-11% nicht deutschstämmigen Mitbürgern sind ca. 3,0% Türken. Somit ist diese Zielgruppe, auch auf Basis ihrer immer mehr wachsenden Kaufkraft (ca. 17 Milliarden Euro pro Jahr), eine beliebte Zielgruppe. Aus diesem Grunde haben wir der korrekten Identifizierung des türkisch/kurdischen Sprach- und Kulturraums besonderes Gewicht verliehen. Das ist oft sehr schwer, da diese Namen für das ungeübte Auge oft große Ähnlichkeiten mit z. B. griechischen, arabischen und bosnischen Namen aufweisen.
Geringfügige Änderungen der Schreibweisen bei den oft für Deutsche ungewohnten Namen führen leider häufig dazu, dass die tatsächliche, türkische Zugehörigkeit nicht mehr zu ermitteln ist. Beispielsweise gibt es im Türkischen viele Namen, die auf „man“ enden, z. B. „Özman“, „Süleyman“, etc., die oft mit zwei „n“ am Ende geschrieben werden und dann nicht mehr zu erkennen sind.
Typische Problemursachen
Insbesondere führen oft folgende Probleme dazu, dass die Identifizierung nicht möglich ist:
- Sehr viele Namen deuten sehr wohl auf einen türkischen Hintergrund hin, dies ist allerdings durch eine große Anzahl Schreibfehler in Vor- und Nachnamen nicht mehr erkennbar. Beispielsweise gibt es falsch geschriebene Namen wie „Süleymann“, „Atamann“, „Dikmann“, die mit einem „n“ geschrieben sehr wohl dem türkischen Sprach- und Kulturraum zuzuordnen wären. Überhaupt lassen sich unzählige Schreibfehler sehr einfach damit erklären, dass hier deutsche Personen versucht haben, Namen aus anderen Sprachräumen aufzunehmen.
- Ein weiteres Problem mit derselben Ursache wie oben gibt es häufig bei der fälschlichen Vertauschung von Vor- und Nachnamen. Viele türkische Vornamen (z. B. „Süleyman“, „Goekhan“, „Bülent“) klingen für Nicht-Türken nach Nachnamen, während türkische Nachnamen (z. B. „Kara“, „Ibis“, etc.) oft für Vornamen gehalten werden. Dadurch entstehen viele weitere Probleme, da der Name durch eine solche Vertauschung letztendlich verstümmelt wird.
- Es gibt einige typische Merkmale für türkische Namen, wie z. B. dass türkische Vornamen praktisch nie auf „d“ enden und fast nie ein „j“ enthalten. Die meisten Namen (z. B. „Ahmet“, „Mohammet“, etc.) kommen jedoch im arabischen Sprach- und Kulturgebiet sehr wohl auch mit einem „d“ am Ende vor, sodass ein „Ahmed Cengiz“ sicherlich ein Türke sein dürfte, allerdings mit falsch geschriebenem Vornamen („Ahmet“ statt „Ahmed“ müsste es heißen). Viele Vornamen, die ein „y“ enthalten (z. B. „Sabriye“, „Fetiye“, etc.), gibt es im ex-jugoslawischen Sprachgebiet (z. B. in Bosnien) mit einem „j“ („Sabrije“, „Fetije“); das Gleiche kommt auch bei den Nachnamen vor (z. B. „Bayram“ und „Bajram“). Diese wahrscheinlichen Türken, die jedoch massive Schreibfehler beinhalten, können von uns natürlich nicht mit dem türkischen Sprachkennzeichen herausgegeben werden. Ein Mailing an diese Personen dürfte auch eher peinlich sein, da die falsche Schreibweise auf Verärgerung stoßen kann.
- Lese- oder Scanfehler der Namen sorgen oft für Probleme, da die dann resultierenden Namen entweder gar nicht existieren oder aber einem anderen Kulturraum angehören. Ein gutes Beispiel hierfür sind häufige Umsetzungen von einem „y“ in ein „g“.
Dies sind nur einige der häufigsten Problemursachen. Ziel unserer Sprach- und Kulturraumbestimmung ist jedoch eine möglichst geringe Fehlerquote bei der Bestimmung, die im Normalfall <1% sein dürfte.
Arabische Namen
Die Klasse der arabischen Namen versteht sich mehr als eine Klasse der muslimischen Länder der arabischen, aber auch der nordafrikanischen Welt. Hier ist besonders die korrekte Abgrenzung gegenüber den sehr ähnlichen, aber dennoch unterschiedlichen Namen des türkischen und bosnischen Sprach- und Kulturraums wichtig.
Asiatische Namen
Zu der Gruppe der asiatischen Namen zählen in allererster Linie Chinesen, Vietnamesen, Koreaner (Süd- und Nordkorea) und Japaner.
Deutsche Namen
Beim Aufruf der AS OriginBox wird immer ein Landesparameter mit übergeben, der die vermutete bzw. erwartete Zugehörigkeit der Namen repräsentiert. Dies ist wichtig für Namen, die eigentlich typisch deutsch, englisch und französisch sein können, z. B. „Robert Martin“.
Hier ist sicherlich „Robert“ ein deutscher, englischer und französischer Vorname, genauso ist „Martin“ ein in Deutschland, Großbritannien und Frankreich (und auch noch in anderen Ländern) existierender Nachname. Wenn nun als Landesparameter Deutschland eingestellt wurde, wird als Sprach- und Kulturraum für diesen Namen „German“ ermittelt, da dies der Erwartungshaltung entspricht. Selbstverständlich gehören auch österreichische und schweizerische Namen zu dieser Gruppe.
Weiterlesen
Online-Demo
Probieren Sie es mit einer eigenen Adresse aus.
Die Online-Demo zeigt die Verfahren direkt im Browser. Fragen zu Produkten oder zum Unternehmen beantworten wir gerne persönlich.